La cartelera de Pívot en producción, y los procesos que la alimentan mientras nadie mira
Son las dos y cuarto y el teléfono no vibra. Eso, en esta casa, quiere decir que todo está saliendo bien.
A esa hora, del otro lado, arrancan los procesos que alimentan la cartelera de Pívot: convocatorias uruguayas primero, eventos después, noticias más tarde. Nadie los mira. Cuando me despierto ya hay una tanda de ítems esperando en el inbox.
La cartelera no se llena sola. Se llena mientras yo duermo. La diferencia entre esas dos frases es todo el trabajo: alguien tuvo que escribir las reglas, los filtros y los límites, y esa parte no la hace ningún modelo.
Cinco robots a las dos y cuarto de la mañana
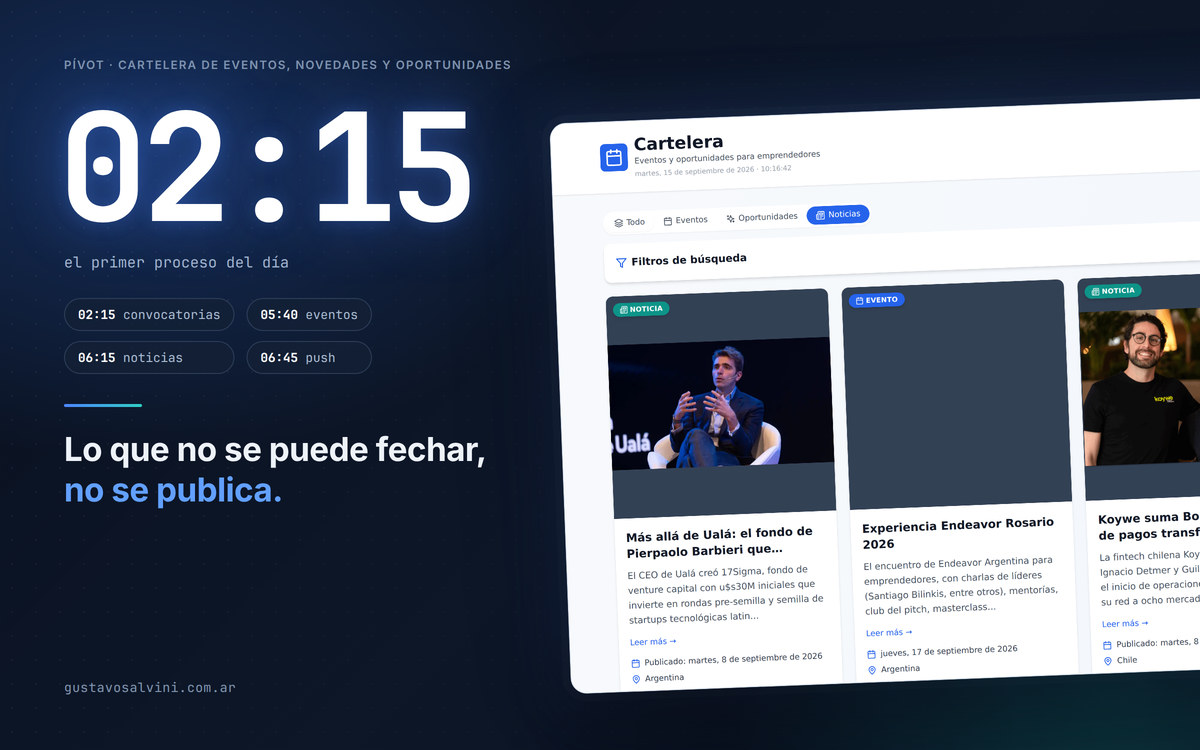
A las 02:15 arranca el primero de cinco procesos que corren solos. Convocatorias uruguayas: eso sale temprano. Después viene el discovery de eventos a las 05:40, el productor de noticias a las 06:15, y a las 06:45 el exporter empuja lo capturado.
Los tres canales escriben en el mismo lugar: archivos JSONL que se acumulan. El exporter los lee, filtra, deduplica y manda el resultado por HTTPS con una clave a un gateway público que hace de relay hacia el webhook. La máquina vive detrás de una VPN: no expone nada entrante y solo empuja hacia afuera. Es la forma más aburrida de conectar dos mundos, y justamente por eso funciona.
%3btext-align:center%3b%7d%23mermaid-0 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-0 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-0 .cluster text%7bfill:%23333%3b%7d%23mermaid-0 .cluster span%7bcolor:%23333%3b%7d%23mermaid-0 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-0 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-0 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-0 .icon-shape%2c%23mermaid-0 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-0 .icon-shape p%2c%23mermaid-0 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-0 .icon-shape rect%2c%23mermaid-0 .image-shape rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker orient='auto' markerHeight='8' markerWidth='8' markerUnits='userSpaceOnUse' refY='5' refX='5' viewBox='0 0 10 10' class='marker flowchart-v2' id='mermaid-0_flowchart-v2-pointEnd'%3e%3cpath style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b' class='arrowMarkerPath' d='M 0 0 L 10 5 L 0 10 z'/%3e%3c/marker%3e%3cmarker orient='auto' markerHeight='8' markerWidth='8' markerUnits='userSpaceOnUse' refY='5' refX='4.5' viewBox='0 0 10 10' class='marker flowchart-v2' id='mermaid-0_flowchart-v2-pointStart'%3e%3cpath style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b' class='arrowMarkerPath' d='M 0 5 L 10 10 L 10 0 z'/%3e%3c/marker%3e%3cmarker orient='auto' markerHeight='11' markerWidth='11' markerUnits='userSpaceOnUse' refY='5' refX='11' viewBox='0 0 10 10' class='marker flowchart-v2' id='mermaid-0_flowchart-v2-circleEnd'%3e%3ccircle style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b' class='arrowMarkerPath' r='5' cy='5' cx='5'/%3e%3c/marker%3e%3cmarker orient='auto' markerHeight='11' markerWidth='11' markerUnits='userSpaceOnUse' refY='5' refX='-1' viewBox='0 0 10 10' class='marker flowchart-v2' id='mermaid-0_flowchart-v2-circleStart'%3e%3ccircle style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b' class='arrowMarkerPath' r='5' cy='5' cx='5'/%3e%3c/marker%3e%3cmarker orient='auto' markerHeight='11' markerWidth='11' markerUnits='userSpaceOnUse' refY='5.2' refX='12' viewBox='0 0 11 11' class='marker cross flowchart-v2' id='mermaid-0_flowchart-v2-crossEnd'%3e%3cpath style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b' class='arrowMarkerPath' d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9'/%3e%3c/marker%3e%3cmarker orient='auto' markerHeight='11' markerWidth='11' markerUnits='userSpaceOnUse' refY='5.2' refX='-1' viewBox='0 0 11 11' class='marker cross flowchart-v2' id='mermaid-0_flowchart-v2-crossStart'%3e%3cpath style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b' class='arrowMarkerPath' d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)' style='' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' id='L_A_C_0' d='M205.852%2c47L212.095%2c47C218.339%2c47%2c230.826%2c47%2c251.578%2c63.335C272.331%2c79.67%2c301.35%2c112.34%2c315.859%2c128.675L330.369%2c145.009'/%3e%3cpath marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)' style='' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' id='L_B_C_0' d='M218.313%2c175L222.479%2c175C226.646%2c175%2c234.979%2c175%2c242.646%2c175C250.313%2c175%2c257.313%2c175%2c260.813%2c175L264.313%2c175'/%3e%3cpath marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)' style='' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' id='L_D_C_0' d='M217.422%2c303L221.737%2c303C226.052%2c303%2c234.682%2c303%2c253.507%2c286.665C272.331%2c270.33%2c301.35%2c237.66%2c315.859%2c221.325L330.369%2c204.991'/%3e%3cpath marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)' style='' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' id='L_C_E_0' d='M445.703%2c175L449.87%2c175C454.036%2c175%2c462.37%2c175%2c470.036%2c175C477.703%2c175%2c484.703%2c175%2c488.203%2c175L491.703%2c175'/%3e%3cpath marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)' style='' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' id='L_E_F_0' d='M738.906%2c175L743.073%2c175C747.24%2c175%2c755.573%2c175%2c763.24%2c175C770.906%2c175%2c777.906%2c175%2c781.406%2c175L784.906%2c175'/%3e%3cpath marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)' style='' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' id='L_F_G_0' d='M965.391%2c175L969.557%2c175C973.724%2c175%2c982.057%2c175%2c989.724%2c175C997.391%2c175%2c1004.391%2c175%2c1007.891%2c175L1011.391%2c175'/%3e%3cpath marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)' style='' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' id='L_G_H_0' d='M1139.438%2c175L1143.604%2c175C1147.771%2c175%2c1156.104%2c175%2c1163.771%2c175C1171.438%2c175%2c1178.438%2c175%2c1181.938%2c175L1185.438%2c175'/%3e%3cpath marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)' style='' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' id='L_H_I_0' d='M1349.078%2c175L1353.245%2c175C1357.411%2c175%2c1365.745%2c175%2c1373.411%2c175C1381.078%2c175%2c1388.078%2c175%2c1391.578%2c175L1395.078%2c175'/%3e%3cpath marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)' style='' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' id='L_I_J_0' d='M1588.938%2c175L1593.104%2c175C1597.271%2c175%2c1605.604%2c175%2c1613.271%2c175C1620.938%2c175%2c1627.938%2c175%2c1631.438%2c175L1634.938%2c175'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg transform='translate(0%2c 0)' class='label'%3e%3cforeignObject height='0' width='0'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' class='labelBkg' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg transform='translate(0%2c 0)' class='label'%3e%3cforeignObject height='0' width='0'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' class='labelBkg' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg transform='translate(0%2c 0)' class='label'%3e%3cforeignObject height='0' width='0'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' class='labelBkg' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg transform='translate(0%2c 0)' class='label'%3e%3cforeignObject height='0' width='0'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' class='labelBkg' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg transform='translate(0%2c 0)' class='label'%3e%3cforeignObject height='0' width='0'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' class='labelBkg' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg transform='translate(0%2c 0)' class='label'%3e%3cforeignObject height='0' width='0'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' class='labelBkg' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg transform='translate(0%2c 0)' class='label'%3e%3cforeignObject height='0' width='0'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' class='labelBkg' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg transform='translate(0%2c 0)' class='label'%3e%3cforeignObject height='0' width='0'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' class='labelBkg' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg transform='translate(0%2c 0)' class='label'%3e%3cforeignObject height='0' width='0'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' class='labelBkg' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg transform='translate(113.15625%2c 47)' id='flowchart-A-0' class='node default'%3e%3crect height='78' width='185.390625' y='-39' x='-92.6953125' style='' class='basic label-container'/%3e%3cg transform='translate(-62.6953125%2c -24)' style='' class='label'%3e%3crect/%3e%3cforeignObject height='48' width='125.390625'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='nodeLabel'%3e%3cp%3e02:15%3cbr /%3econvocatorias UY%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg transform='translate(357.0078125%2c 175)' id='flowchart-C-1' class='node default'%3e%3crect height='54' width='177.390625' y='-27' x='-88.6953125' style='' class='basic label-container'/%3e%3cg transform='translate(-58.6953125%2c -12)' style='' class='label'%3e%3crect/%3e%3cforeignObject height='24' width='117.390625'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='nodeLabel'%3e%3cp%3ecapturas JSONL%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg transform='translate(113.15625%2c 175)' id='flowchart-B-2' class='node default'%3e%3crect height='78' width='210.3125' y='-39' x='-105.15625' style='' class='basic label-container'/%3e%3cg transform='translate(-75.15625%2c -24)' style='' class='label'%3e%3crect/%3e%3cforeignObject height='48' width='150.3125'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='nodeLabel'%3e%3cp%3e05:40%3cbr /%3ediscovery de eventos%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg transform='translate(113.15625%2c 303)' id='flowchart-D-4' class='node default'%3e%3crect height='78' width='208.53125' y='-39' x='-104.265625' style='' class='basic label-container'/%3e%3cg transform='translate(-74.265625%2c -24)' style='' class='label'%3e%3crect/%3e%3cforeignObject height='48' width='148.53125'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='nodeLabel'%3e%3cp%3e06:15%3cbr /%3eproductor de noticias%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg transform='translate(617.3046875%2c 175)' id='flowchart-E-7' class='node default'%3e%3crect height='78' width='243.203125' y='-39' x='-121.6015625' style='' class='basic label-container'/%3e%3cg transform='translate(-91.6015625%2c -24)' style='' class='label'%3e%3crect/%3e%3cforeignObject height='48' width='183.203125'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='nodeLabel'%3e%3cp%3e06:45%3cbr /%3eexporter: filtra y deduplica%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg transform='translate(877.1484375%2c 175)' id='flowchart-F-9' class='node default'%3e%3crect height='78' width='176.484375' y='-39' x='-88.2421875' style='' class='basic label-container'/%3e%3cg transform='translate(-58.2421875%2c -24)' style='' class='label'%3e%3crect/%3e%3cforeignObject height='48' width='116.484375'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='nodeLabel'%3e%3cp%3egateway HTTPS%3cbr /%3eX-API-Key%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg transform='translate(1077.4140625%2c 175)' id='flowchart-G-11' class='node default'%3e%3crect height='54' width='124.046875' y='-27' x='-62.0234375' style='' class='basic label-container'/%3e%3cg transform='translate(-32.0234375%2c -12)' style='' class='label'%3e%3crect/%3e%3cforeignObject height='24' width='64.046875'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='nodeLabel'%3e%3cp%3ewebhook%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg transform='translate(1269.2578125%2c 175)' id='flowchart-H-13' class='node default'%3e%3crect height='54' width='159.640625' y='-27' x='-79.8203125' style='' class='basic label-container'/%3e%3cg transform='translate(-49.8203125%2c -12)' style='' class='label'%3e%3crect/%3e%3cforeignObject height='24' width='99.640625'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='nodeLabel'%3e%3cp%3einbox pending%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg transform='translate(1494.0078125%2c 175)' id='flowchart-I-15' class='node default'%3e%3crect height='54' width='189.859375' y='-27' x='-94.9296875' style='' class='basic label-container'/%3e%3cg transform='translate(-64.9296875%2c -12)' style='' class='label'%3e%3crect/%3e%3cforeignObject height='24' width='129.859375'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='nodeLabel'%3e%3cp%3ecuradur%c3%ada humana%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg transform='translate(1727.640625%2c 175)' id='flowchart-J-17' class='node default'%3e%3crect height='54' width='177.40625' y='-27' x='-88.703125' style='' class='basic label-container'/%3e%3cg transform='translate(-58.703125%2c -12)' style='' class='label'%3e%3crect/%3e%3cforeignObject height='24' width='117.40625'%3e%3cdiv style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b' xmlns='http://www.w3.org/1999/xhtml'%3e%3cspan class='nodeLabel'%3e%3cp%3ecartelera p%c3%bablica%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/svg%3e)
Dos reglas ordenan esto. El dedupe por (source, external_id): si un proceso se reenvía, nada se duplica. Y nada se publica solo: todo cae al inbox como pending y una persona decide. Cada canal corta en 8 ítems por corrida: prefiero ocho cosas buenas que ochenta regulares.
Si querés ver el resultado, está en pivot.lat/cartelera-eventos.
Las fuentes no quieren ser leídas
Arranqué con 75 fuentes de noticias y solo 10 tenían alguna forma de saber la fecha. Las otras devolvían titulares sin cuándo. Sin fecha verificable, la noticia se descarta: nunca se estima. Después del barrido quedaron 44 de 75.
Las vías más comunes son tres. El feed trae la fecha exacta. El sitemap de noticias la trae nota por nota. Y a veces la fecha está en los datos estructurados del artículo, que el extractor de contenido no ve, así que hay que pedir la página cruda con curl.
Hay cuatro trampas. Los sitemaps de WordPress vienen paginados y el archivo sin número trae los más viejos. Un sitemap de 2013 se disfraza de fresco porque la portada tiene fecha de hoy; la señal es la mediana de las 20 fechas más nuevas. Fechas futuras significan sitemap de agenda, no de noticias. Un certificado TLS incompleto se disfraza de bloqueo de bots.
La rotación la armó Santiago Aramendía sobre un CSV de 112: quedaron 75 fuentes elegibles, 8 de Uruguay, 43 de prioridad A y 24 de prioridad B. Las prioridades A, B y C las definió él. Cada corrida toma seis en tres anillos, 2 de Uruguay, 3 de A y 1 de B. El anillo uruguayo se barre cada 4 corridas, así que ninguna fuente se repite hasta agotar su anillo.
El portal de compras del Estado uruguayo publica un RSS con 857 ítems en el feed general, 597 en una ventana semanal y 13 vigentes para un inciso. Eso permitiría cambiar scraping con modelo por parseo directo.
El día que el radar devolvió el diario equivocado
Una mañana le pedí la página de un medio uruguayo a un extractor y me devolvió el contenido de otro. Le pedí el de ese otro y me devolvió el del primero. No era un problema de mi código de búsqueda.
El caché emparejaba los resultados con las URLs por posición, y el proveedor devuelve primero los aciertos y deja los errores al final. Encima, el proveedor actual rota el orden incluso cuando todo sale bien.
En un radar que atribuye cada noticia a su medio, atribuir mal es publicar contenido ajeno como propio. El arreglo fue corregir el emparejamiento, purgar 206 entradas cruzadas de las cachés, dejar un auditor re-ejecutable y verificar que el contenido corresponda al dominio antes de atribuir.
El segundo modo de falla enseñó más. El conversor de convocatorias corrió del 07/09 al 13/09 con estado ok sin escribir un solo archivo, porque le pedía leer archivos a un proceso que solo tenía herramientas web. Resultado: 1 oportunidad contra 21 noticias. La firma del canal roto es la asimetría, un canal con un archivo mientras sus hermanos acumulan uno por día.
La lección: last_status: ok mide que el proceso terminó su turno, no que produjo algo. La verificación se hace en el disco, no en el reporte. El fix fue determinista, 13 de 13 ítems aceptados y una segunda corrida que devuelve 0 novedades.
Curar es el producto
Lo que hace que la cartelera sirva es el filtro, no el volumen de datos. El volumen se consigue; el criterio, no. Y el criterio no se compra. La orquestación es el producto.
Las reglas de caducidad son decisiones editoriales escritas como código. Un evento se vence a la medianoche del día siguiente. Una oportunidad queda +7 días. Una noticia, +3 días. Un evento vencido no le sirve a nadie, y una noticia de hace dos semanas tampoco. Por eso esas reglas viven en el código y no en un documento aparte que nadie lee.
La otra decisión es humana y la sostengo: la máquina propone, la persona decide. Todo pasa por el inbox como pending. Elegir qué ve alguien cuando abre la cartelera es una decisión de producto, no un detalle de implementación. Hoy sigue igual, y va a seguir igual: automatizar esa parte sería perder lo que hace distinta a la cartelera.
Esto es lo que Brainsource abastece para Pívot: los cinco procesos, las 75 fuentes, el inbox y la cartelera pública. La misma arquitectura se puede volver a armar para otra ciudad, otro rubro u otro país.
Saludos sin apuro. Gustavo.